企业出海 · DeepEge 编辑团队
RAG知识库是什么:RAG意思、读法、搭建6步与区别对比
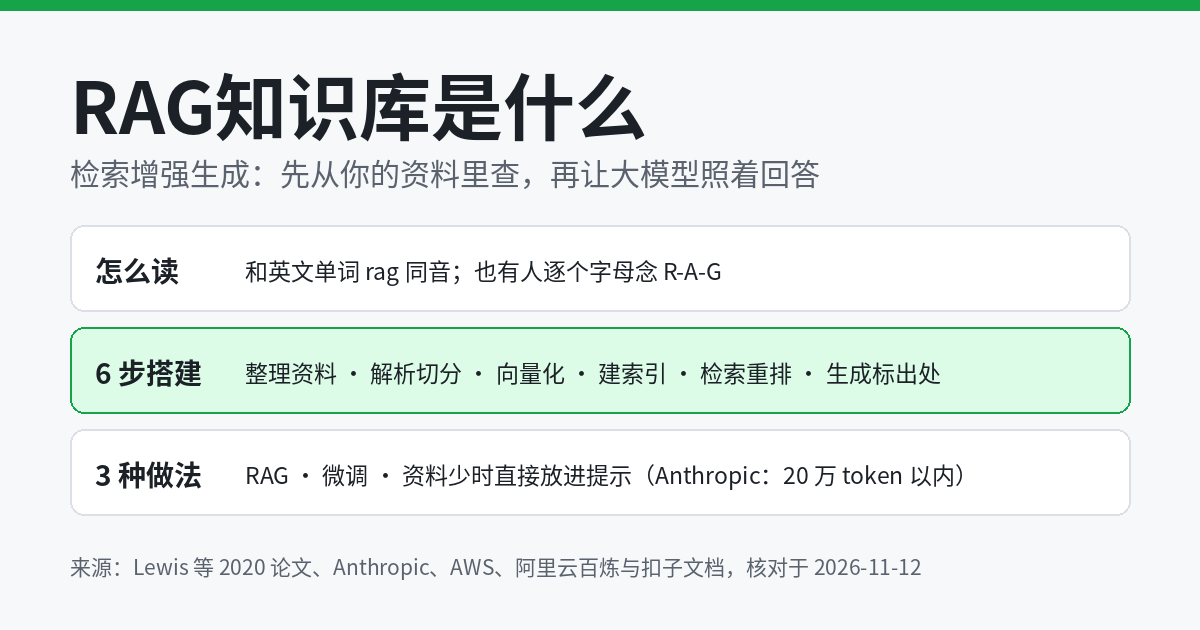
RAG知识库是用检索增强生成(RAG)技术搭起来的知识库:先把你的文档切成小段、建好索引,有人提问时系统先从里面查出最相关的几段,再交给大模型照着这些资料写答案。RAG 是 Retrieval-Augmented Generation 的缩写,这个名字出自 2020 年 Lewis 等人的论文。
- RAG是什么意思:检索(Retrieval)+ 增强(Augmented)+ 生成(Generation),也就是“先查资料,再回答”。
- RAG怎么读:海外常见读法和英文单词 rag 一样(/ræɡ/),也有人逐个字母念 R-A-G。
- RAG知识库怎么搭:整理资料、解析切分、向量化、建索引、检索与重排、生成并标出处,共 6 步。
- RAG和微调的区别:RAG 不改模型,换文档就能更新知识;微调要用数据重新训练模型,更适合让输出贴合组织风格。
- RAG知识库能减少AI乱编,但搜不到或搜错时模型仍可能去猜,价格、数字这类信息还得人工核对。
RAG是什么意思:检索增强生成
RAG是“检索增强生成”,指大模型在回答之前,先从外部资料里检索相关内容,把查到的内容和问题一起交给模型,再生成答案。Anthropic 的解释是:RAG 从知识库里取出相关信息,附加到用户的提示里,以此明显改善模型的回答。
这个词出自 Patrick Lewis 等人 2020 年的论文《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》(arXiv 2005.11401),作者来自 Facebook AI Research、伦敦大学学院和纽约大学。论文把模型参数里学到的知识叫“参数记忆”,把外挂的资料索引叫“非参数记忆”:当时的做法是把维基百科切成约 2100 万段、每段 100 个词,建成向量索引,让模型先检索、再生成。
论文里有个实验能说明 RAG 的用处:研究者分别用 2016 年和 2018 年的维基百科建索引,问 82 位前后换过人的各国领导人是谁。索引和年份对得上时,正确率分别是 70% 和 68%;对不上时只有 12% 和 4%。也就是说,不用重新训练模型,换掉资料索引就能更新它“知道”的东西。
RAG是什么的缩写
RAG 是 Retrieval-Augmented Generation 三个英文单词的首字母缩写。Retrieval 是检索,Augmented 是增强,Generation 是生成。英文里也写作 retrieval-augmented generation,中文资料常译作“检索增强生成”或“检索增强生成技术”。
RAG怎么读
RAG 在海外通常按单词读,和英文单词 rag(抹布、碎布)同音,剑桥词典给的音标是 /ræɡ/。韩国 Hancom 的官方博客提到,海外读作 [rag],韩国有人逐个字母念 [R-A-G]。两种读法同行都听得懂,跟着团队习惯就行。
这个名字并不是特意起的。英伟达官方博客采访论文第一作者 Patrick Lewis 时,他为这个“不太好听”的缩写道过歉:要是早知道这项工作会传得这么广,他们一定会在名字上多花点心思,只是写论文时谁也没想到更好的名字。
RAG知识库和普通知识库有什么区别
RAG知识库和普通知识库装的可以是同一批资料,区别在于谁来用、怎么查。AWS 对知识库的定义是“按照特定组织方式存储的结构化或非结构化信息的集合”,而 RAG 是一种用法:生成内容之前先从知识库里检索,把结果作为上下文交给模型。阿里云百炼的文档也把知识库称作 RAG 平台的核心实体,它把文档、切片、向量和索引配置组织在一起。
| 对比项 | 普通知识库(帮助中心、Wiki、共享文档) | RAG知识库 |
|---|---|---|
| 谁来用 | 人自己搜、自己读 | 大模型先检索,再写答案 |
| 资料怎么存 | 按目录、标签整理成一篇篇文档 | 切成小段,建向量索引和关键词索引 |
| 怎么查 | 关键词搜索,结果是文档列表 | 按语义相似度和关键词查出几段原文 |
| 产出 | 找到文档,自己总结 | 直接生成答案,可附上引用来源 |
| 维护重点 | 文档写清楚、目录好找 | 文档准确、切分合理、索引及时更新 |
打个比方:普通知识库是给人翻的书架,RAG知识库是先帮模型把要看的那几页翻出来。
RAG知识库怎么搭建:6个步骤
搭一个RAG知识库通常分 6 步:前 4 步提前把资料处理好,后 2 步在每次提问时实时运行。Anthropic、AWS 和阿里云百炼文档描述的流程基本一致,下面按顺序说明每步要做什么、容易在哪出问题。

- 整理资料:选出要让 AI 参考的文档,删掉旧版本和重复内容,每份资料写清版本日期。AWS 提醒,过时数据、重复内容混进知识库,会直接拉低回答质量。
- 解析与切分:把 PDF、Word、网页里的文字和表格提出来,再切成小段。扣子的文档说得很清楚:分块太大,会混进不相关的信息、降低检索准确性;分块太小,又会丢掉上下文。Anthropic 介绍的常见做法是每段不超过几百个 token,阿里云百炼知识库默认的最大分段长度是 600。扫描件和复杂表格要选带 OCR 的精细解析。
- 向量化:用嵌入(Embedding)模型把每段文字转成一串数字,也就是向量。意思相近的段落,向量也离得近。Hancom 博客举的例子是:搜“汽车维修费”,也能找到写着“车辆保养费用”的段落。
- 建索引、存进向量库:把向量存进向量数据库,方便按语义相似度查找;最好同时建关键词索引。Anthropic 举过一个例子:用户查错误码“TS-999”,向量检索可能只找到泛泛讲错误码的段落,关键词检索(BM25)才能精确命中。
- 检索与重排:用户提问后,系统把问题也转成向量,查出最相关的若干段,可以再用重排(Rerank)模型二次排序。Dify 的混合检索就是同时跑全文检索和向量检索,再选出最佳结果。
- 生成并标出处:把查到的段落和问题一起交给大模型,提示里写明“只根据资料回答,资料里没有就说不知道”,并要求标出引用了哪一段。Dify 的应用里有“引用和归属”开关,可以把来源显示给用户。
搭完别急着上线。Dify 有“召回测试”,阿里云百炼有“命中测试”,都能直接输入问题看查出了哪几段。我们建议拿 20 个左右真实用户问过的问题逐个测:先看检索到的段落对不对,再看答案有没有超出这些段落。检索这一步就错了的,先改切分和索引,光改提示词很难解决。
RAG知识库搭建需要什么硬件
RAG知识库要不要买服务器,取决于你用云平台还是自己部署。用扣子、阿里云百炼这类云平台,资料传上去就行,不需要自己的服务器。自己部署开源方案时,官方给的配置是:
- RAGFlow:建议起步配置 4 核 CPU、16 GB 内存、50 GB 可用磁盘,Docker 不低于 24.0.0;开源版 1.0 的版面分析、OCR 和表格识别用 CPU 推理。
- Dify:最低 CPU 2 核、内存 4 GiB。
这两项都只是平台本身的要求。如果还要在本机运行大模型或嵌入模型,需要另外满足这些模型的资源要求,RAGFlow 的文档也是这么提示的。资料量也会影响内存:Lewis 等人的论文里,整个维基百科的向量索引放在内存里约需 100 GB,压缩后约 36 GB。
用哪个平台搭?4个常见平台对比
RAG框架和平台没有哪个绝对最好,先看你要不要写代码、资料能不能放到云上。下表只比较知识库相关的功能,信息来自各平台官方文档,核对于 2026-11-12。
| 平台 | 类型 | 知识库能做什么 | 费用和门槛 | 适合谁 |
|---|---|---|---|---|
| 扣子 | 云平台 | 文本、表格、图片三类知识库;可从本地文档、网页、飞书、微信公众号、Notion 导入 | 每个知识库最多 300 个文件,文本单文件不超过 100 MB;个人免费版知识库空间 1 GB;低代码开发平台已不再向新注册用户开放 | 已有扣子账号、想在智能体里挂资料的人 |
| 阿里云百炼 | 云平台 | 文档搜索、数据查询、图片问答、音视频搜索四类;自动解析、切片、向量化 | 标准版 0.03 元/知识库/小时,新用户有一次性 720 小时免费额度(开通后 30 天内有效);模型调用另计;删掉知识库才停止计费 | 不写代码、想先在云上验证效果的团队 |
| Dify | 开源,可自部署,也有云服务 | 通用分段和父子分段;向量、全文、混合检索;可选 Rerank | 自部署最低 2 核 CPU、4 GiB 内存;许可证是基于 Apache 2.0 加附加条件的 Dify Open Source License | 想把知识库和工作流、应用放在一起的团队 |
| RAGFlow | 开源,自部署 | 带版面分析、OCR、表格识别的文档解析 | Apache-2.0 许可;建议 4 核 CPU、16 GB 内存、50 GB 磁盘 | 扫描件、复杂 PDF 多,资料要留在自己服务器上的团队 |
怎么选:不想写代码、资料可以上云,先用阿里云百炼或扣子试;资料不能出内网,就看 Dify 或 RAGFlow;扫描件和表格多,重点测文档解析效果。要自己写代码的开发者,还会用 LangChain 这类开源库把大模型、嵌入模型和知识库串起来。
RAG和微调有什么区别
RAG 和微调的区别在于改不改模型:RAG 不动模型,回答时把查到的资料塞进提示;微调是用你的数据继续训练,改的是模型参数。AWS 的规范性指导给出的建议是:要做基于自有文档的问答,先从 RAG 开始;要让模型做汇总这类别的任务,再考虑微调。两者也可以组合使用。
还有第三种更简单的办法:资料不多时直接全部放进提示。Anthropic 2024 年 9 月写道,如果知识库小于 20 万 token(约 500 页材料),可以把整个知识库直接放进提示,不需要 RAG;资料再多,才需要 RAG 这种能扩展的方案。

| 对比项 | RAG | 微调 | 直接把资料放进提示 |
|---|---|---|---|
| 改不改模型 | 不改 | 改,用数据继续训练 | 不改 |
| 资料更新 | 换文档、重建索引即可;AWS 称几分钟内就能整合最新文档 | 要重新训练,按模型大小需要几小时到几天 | 改资料原文,每次请求都带上 |
| 能否给出处 | 能引用来源 | AWS 指出微调模型的回答不提供来源 | 可以要求标出处 |
| 擅长 | 基于自有文档问答 | 让输出贴合组织风格、做汇总这类任务 | 资料少(Anthropic:20 万 token 以内) |
| 短板 | AWS 称汇总整份文档时效果不佳 | 需要懂 LoRA、PEFT 等技术,可能要数据科学家 | 资料一多就放不进模型的上下文 |
RAG和向量数据库是什么关系
向量数据库是RAG知识库里的一个组件,负责存向量、按语义相似度查找,RAG 是整套“检索再生成”的做法。两者不能画等号:RAG 也可以只用关键词检索,Lewis 的论文就把向量检索换成 BM25 关键词检索做过对比,事实核查任务上 BM25 反而效果最好;Dify 的“经济”索引模式也只用倒排索引,不消耗 token。常见的向量数据库有 Milvus、Pinecone、Chroma 等,PostgreSQL 也可以装 pgvector 扩展来存向量。
RAG和大模型、智能体、工作流的关系
RAG 是给大模型配的“查资料”环节,本身不是一个模型。大模型的原理见AI大模型是什么:原理、3类模型与营销用法。在AI工作流里,RAG 通常就是那个“知识检索”节点,见AI工作流是什么:5种模式、搭建4步与平台对比;智能体则可以自己决定什么时候去查知识库,见AI智能体是什么:组成、区别对比表与5项检查。
RAG知识库有哪些局限:搜不到时仍会猜
RAG知识库能减少AI乱编,但不能保证答案一定对。常见的问题有四类:
- 该找的没找到:传统做法把文档切块时会丢掉上下文。Anthropic 举的例子是,一段只写着“公司收入比上季度增长 3%”的文字,单独看不出是哪家公司、哪个季度,很难被检索到。它的测试里(用表现最好的嵌入模型、取前 20 段),传统检索漏掉相关内容的比例平均是 5.7%,给每段补上下文并加上重排后降到 1.9%。
- 找到了也可能写出资料外的内容:模型会把检索到的资料和自己参数里的知识混在一起用。Lewis 的论文发现,在 Natural Questions 测试中,即使检索到的文档里都没有正确答案,RAG 仍有 11.8% 能答对,说明答案不全来自你的资料。资料里没有的,它也可能去猜,这就是AI幻觉,类型和减少办法见AI幻觉是什么:类型、真实案例与6个减少办法。
- 资料本身错了:知识库里的价格过期、版本混杂,模型会照着错的写。
- 不擅长通读全文:AWS 指出 RAG 汇总整份文档的效果不好,因为它每次只看查出来的几段。
成本也要算进去。以阿里云百炼为例,知识库从创建成功起按运行时长计费,删掉整个知识库才停止计费;向量化、重排和问答模型的调用另外按 token 计费,官方文档说重排费用是检索费用的主要部分。
RAG是不是过时了
RAG没有过时,适用范围变清楚了。模型能读的上下文越来越长,资料少的场景确实可以不用 RAG:Anthropic 给的分界线是 20 万 token(约 500 页)。资料超过这个量、要经常更新、要标出处时,仍然需要先检索再生成。Anthropic 2024 年 9 月发布的“上下文检索”,正是在改进 RAG 的检索这一步。
营销团队怎么用RAG知识库
营销团队用RAG知识库,主要是让AI写内容时先查自家资料,少编卖点和参数。适合放进去的资料有品牌手册、产品参数表、价格和活动规则、常见问题、过往审核通过的文案,以及不能说的话(夸大用语、未获批的功效)。
资料入库前,我们建议过一遍下面 5 项:
- 每份资料写版本日期,新版上线就删旧版,不让两个价格同时存在。
- 价格、活动单独一张表,到期就改,别埋在长文档里。
- 禁用说法单列一份,写清哪些词不能用、换成什么。
- 一份资料只讲一个产品,避免切块后张冠李戴。
- 每份资料指定负责人,答案出错时知道找谁改。
RAG知识库能让AI有据可查,但发布前仍要人工核对数字、价格、日期和承诺。按《广告法》第四条,广告主要对广告内容的真实性负责,AI写的内容也一样。
引擎AI(Deepege)是我们自己的产品,思路和上面一致:先读你的产品手册、详情页和实拍资料,整理成一份产品档案,后面的文章、口播、视频脚本都从这份档案取材,发布前有内容诊断和用语核查。它是做营销内容的工具,不是通用的RAG搭建平台,要给客服或内部问答搭知识库,还是用上面那些平台。它适合哪些团队,见引擎AI是什么、适合谁。
参考资料(2026-11-12 核对):Lewis 等:Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(arXiv 2005.11401)、Anthropic:Introducing Contextual Retrieval、英伟达博客:What Is Retrieval-Augmented Generation aka RAG、AWS:什么是知识库与 RAG、AWS 规范性指导:比较检索增强生成和微调、阿里云百炼:创建知识库、阿里云百炼:知识库计费说明、扣子:创建文本知识库、扣子:知识库使用限制、Dify 文档:指定索引方式与检索设置、Dify GitHub、RAGFlow GitHub(中文 README)、Hancom 官方博客:What is a RAG Pipeline?、剑桥词典:rag、中国政府网:中华人民共和国广告法。
常见问题
RAG是什么意思?
RAG是检索增强生成(Retrieval-Augmented Generation)的缩写,指大模型回答之前先从知识库或外部资料里检索相关内容,再结合这些内容生成答案。这个名字出自 Patrick Lewis 等人 2020 年的论文。
RAG怎么读?
海外通常按单词读,和英文单词 rag 同音,剑桥词典音标是 /ræɡ/;也有人逐个字母念 R-A-G。两种读法同行都能听懂。
RAG和微调哪个好?
看任务。要基于自有文档问答、资料经常更新、需要标出处,先用 RAG;要让输出贴合组织风格或做汇总这类任务,再考虑微调。AWS 的建议也是先从 RAG 开始,两者还可以组合使用。
搭RAG知识库一定要买GPU服务器吗?
不一定。用阿里云百炼、扣子这类云平台不需要自己的服务器;自己部署时,RAGFlow 建议 4 核 CPU、16 GB 内存、50 GB 磁盘,Dify 最低 2 核 CPU、4 GiB 内存。要在本机运行大模型或嵌入模型,还要另外满足这些模型的资源要求。
RAG是不是过时了?
没有。资料少时可以直接把资料放进提示,Anthropic 给的分界线是 20 万 token(约 500 页);资料更多、要经常更新或要标出处时,仍然需要先检索再生成。
延伸阅读
参考资料
- Lewis 等:Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(arXiv 2005.11401)
- Anthropic:Introducing Contextual Retrieval
- 英伟达博客:What Is Retrieval-Augmented Generation aka RAG
- AWS:什么是知识库与 RAG
- AWS 规范性指导:比较检索增强生成和微调
- 阿里云百炼:创建知识库
- 阿里云百炼:知识库计费说明
- 扣子:创建文本知识库
- 扣子:知识库使用限制
- Dify 文档:指定索引方式与检索设置
- Dify GitHub
- RAGFlow GitHub(中文 README)
- Hancom 官方博客:What is a RAG Pipeline?
- 剑桥词典:rag
- 中国政府网:中华人民共和国广告法