企业出海 · DeepEge 编辑团队
国内AI大模型十强:2026年10月排名榜单、豆包和DeepSeek对比与按用途选法
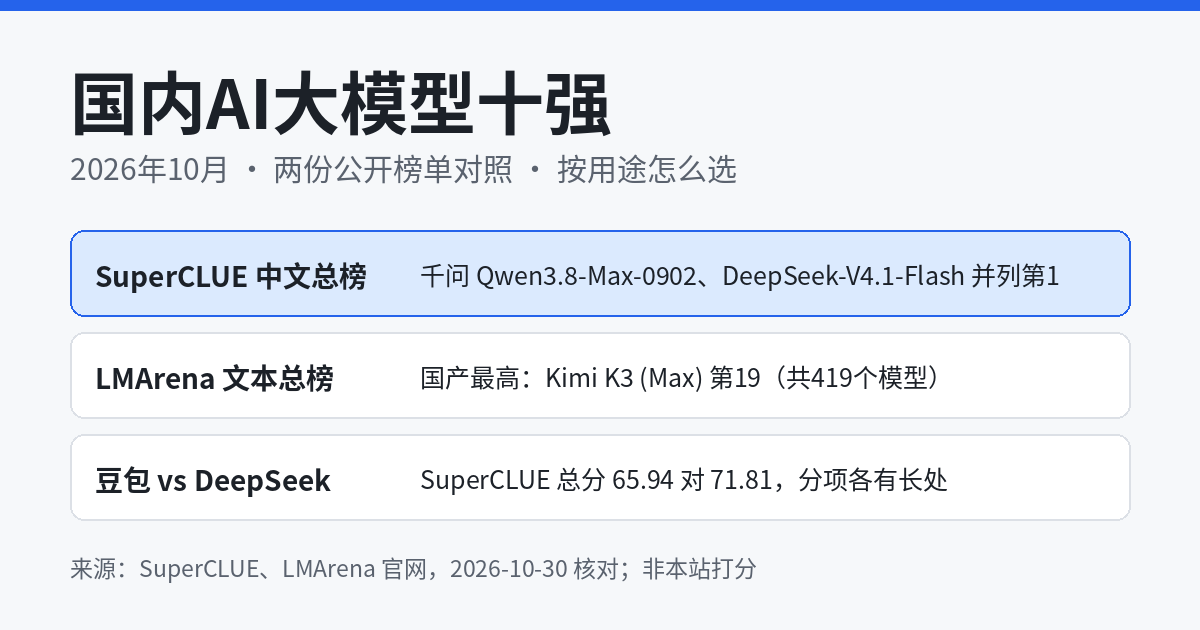
国内AI大模型十强怎么排,可以看两份公开榜单:按 SuperCLUE 2026 年 7 月中文总榜(补充版),阿里千问 Qwen3.8-Max-0902 和 DeepSeek-V4.1-Flash 并列第 1;按 LMArena 10 月 27 日的文本总榜,排名最高的国产模型是 Kimi K3。
SuperCLUE 只给国内模型排名,LMArena 把国内外模型放在一起、按用户投票排。本页数据核对于 2026-10-30,榜单更新后我们会在这里同步。
- SuperCLUE 总榜前 10 名档位里有 16 个模型,来自阿里、DeepSeek、智谱、月之暗面、字节跳动、腾讯、MiniMax、百度、美团 9 家公司;第 11 名是小米。
- LMArena 文本总榜有 419 个模型,第 1 名是 Google 的 Gemini 4 Carbon (High);国产最高的 Kimi K3 (Max) 排第 19。
- 豆包和 DeepSeek 哪个好:在 SuperCLUE 总榜上,DeepSeek-V4.1-Flash 71.81 分,豆包 Doubao-Seed-2.1-pro 65.94 分;豆包在科学推理、精确指令遵循和任务规划三项更高。
- 写文案、做图、做视频要看不同的榜:文字看总榜和“精确指令遵循”“幻觉控制”两项,图片看文生图榜,视频看文生视频榜。
- 榜单只说明“在这套题或这批投票里”的表现。不在榜上的模型可能只是没参评,App 里用的版本也不一定是榜上测的版本。
国内AI大模型十强是哪些(SuperCLUE 中文总榜)
SuperCLUE 中文通用总榜是专门给国内大模型排名的公开榜单之一,海外模型和部分国内模型只放在表里作参考、不参与排名。最新一版是 2026 年 7 月总榜的补充版,共 18 个模型,最新一批评测日期是 2026 年 9 月 10–11 日。考题分 6 个维度:数学推理、科学推理、幻觉控制、精确指令遵循、智能体编程、智能体任务规划,补充评测共 507 题。
SuperCLUE 规定总分相差 1 分以内视为并列,所以同一个名次下会有几个模型。下表是官网总榜前 12 个名次(核对于 2026-10-30):
| 名次 | 模型 | 公司 | 总分 |
|---|---|---|---|
| 1 | Qwen3.8-Max-0902(max) | 阿里 | 72.62 |
| 1 | DeepSeek-V4.1-Flash(max) | DeepSeek | 71.81 |
| 2 | Qwen3.8-Max(max) | 阿里 | 71.48 |
| 2 | GLM-5.3(max) | 智谱 | 71.29 |
| 2 | Kimi-K3(max) | 月之暗面 | 70.68 |
| 3 | DeepSeek-V4-Pro-0813(max) | DeepSeek | 70.10 |
| 4 | GLM-5.3-Flash(max) | 智谱 | 68.10 |
| 5 | Qwen3.8-Flash(max) | 阿里 | 66.41 |
| 5 | Doubao-Seed-2.1-pro(high) | 字节跳动 | 65.94 |
| 5 | DeepSeek-V4-Flash(max) | DeepSeek | 65.60 |
| 6 | DeepSeek-V4-Pro(max) | DeepSeek | 64.40 |
| 7 | GLM-5.2(max) | 智谱 | 63.27 |
| 8 | Hy3(high) | 腾讯 | 62.13 |
| 9 | MiniMax-M3 | MiniMax | 56.90 |
| 10 | ERNIE 5.1(max) | 百度 | 54.56 |
| 10 | LongCat-2.0 | 美团 | 54.22 |
| 11 | MiMo-V2.5-Pro | 小米 | 53.01 |
| 12 | Step-3.7-Flash(high) | 阶跃星辰 | 48.16 |
如果“十强”指公司,按每家在这张榜上最好的名次数,正好是 10 家:阿里(第 1)、DeepSeek(第 1)、智谱(第 2)、月之暗面(第 2)、字节跳动(第 5)、腾讯(第 8)、MiniMax(第 9)、百度(第 10)、美团(第 10)、小米(第 11)。这份名单是我们按 SuperCLUE 名次整理的,不是我们自己的打分。

这张榜上没有出现讯飞星火、华为盘古等模型,原因可能是没有参评或没有列入排名,不能据此说它们更弱。
世界AI大模型排名里,国产模型排第几(LMArena)
LMArena 是按用户投票计算分数的公开榜单,国内外模型放在一起排。它的文本总榜在 2026 年 10 月 27 日更新,共 419 个模型、900 多万票,第 1 名是 Google 的 Gemini 4 Carbon (High)(1528 分,标注为初步结果)。
国产模型在这张榜上的位置(核对于 2026-10-30):
| 名次 | 模型 | 公司 | 分数 |
|---|---|---|---|
| 19 | Kimi K3 (Max) | 月之暗面 | 1488±4 |
| 24 | Qwen3.8-Max | 阿里 | 1482±5 |
| 28 | GLM-5.3 (Max) | 智谱 | 1481±5 |
| 29 | MiMo-V2.6-Pro | 小米 | 1480±9 |
| 35 | DeepSeek-V4.1-Flash (Max) | DeepSeek | 1476±6 |
| 51 | ERNIE 5.1 | 百度 | 1467±5 |
| 68 | Dola Seed 2.0 Pro | 字节跳动 | 1456±3 |
| 75 | Hy3 | 腾讯 | 1454±6 |
| 98 | MiniMax-M3 | MiniMax | 1439±4 |
分数后面的“±”是误差范围,LMArena 还给每个模型标了名次区间。比如 Kimi K3 (Max) 名次是 19,区间是 10–30。第 19 到第 35 名之间分数只差 12 分,这一段里的先后不要看得太重。
豆包和DeepSeek哪个好
只看 SuperCLUE 总分,DeepSeek-V4.1-Flash(71.81 分,并列第 1)高于豆包的 Doubao-Seed-2.1-pro(65.94 分,第 5 档);分项上两者各有长处。
| 维度(SuperCLUE) | DeepSeek-V4.1-Flash | Doubao-Seed-2.1-pro | Qwen3.8-Max-0902 |
|---|---|---|---|
| 总分 | 71.81 | 65.94 | 72.62 |
| 数学推理 | 84.21 | 75.44 | 78.95 |
| 科学推理 | 70.18 | 77.19 | 75.44 |
| 幻觉控制 | 87.16 | 78.85 | 86.19 |
| 精确指令遵循 | 40.00 | 42.86 | 42.86 |
| 智能体编程 | 71.58 | 51.58 | 70.53 |
| 智能体任务规划 | 79.84 | 84.95 | 89.53 |
具体到用法:
- 写代码、做数学题:DeepSeek 这两项分数明显更高。
- 按资料写、不想它乱编:“幻觉控制”测的是根据给定材料写摘要、做问答时会不会加原文没有的内容,DeepSeek 和千问都在 86 分以上,豆包 78.85。
- 排计划、拆任务:豆包和千问的“任务规划”分数更高。
- 千问和豆包哪个好:同一张榜上千问 Qwen3.8-Max-0902 总分 72.62,六项里有四项高于豆包,科学推理低于豆包(75.44 对 77.19),精确指令遵循持平(都是 42.86)。
另外,榜上测的是带版本号的 API 模型。豆包、DeepSeek、千问的 App 里用哪个版本、开没开深度思考,会让实际效果和榜单不一样。写公文、写营销文案这类具体任务,最稳的办法是拿同一份资料、同一段提示词各跑几次再比。
写文案、做图、做视频分别看哪个榜
不同内容要看不同的榜:文字类看语言模型榜,图片看文生图榜,视频看文生视频榜。同一家公司在三张榜上的位置可能差很多。

| 用途 | 看哪个榜 | 国产模型位置(核对于 2026-10-30) |
|---|---|---|
| 写文案、脚本 | SuperCLUE 总榜,重点看“精确指令遵循”“幻觉控制” | 见上面两节 |
| 做图(海报、商品图) | LMArena 文生图榜(10 月 26 日更新,82 个模型) | 阿里 Qwen-Image-3.0-Pro 第 12、字节 Seedream 5.0 Pro 第 14、腾讯 HunyuanImage 3.0 第 33;第 1 是 OpenAI GPT-Image-2.5 Sunburst |
| 做视频 | LMArena 文生视频榜(9 月 21 日更新,48 个模型) | 字节 Dreamina Seedance 2.0 (720p) 第 5、阿里 Wan 3.0 第 6、MiniMax H3 第 8、快手可灵 Kling 2.6 Pro 第 29;第 1 是 Google Gemini Omni 1.1 Flash |
写营销文案时,“精确指令遵循”这一项最值得看:它测的是能不能按规定格式、字数、必须出现的内容来写。SuperCLUE 补充版 18 个模型在这一项上全部低于 50 分,最高的是 DeepSeek-V4-Pro(max) 的 49.52。也就是说,“标题不超过 20 字”“必须写上价格”这类要求,排名靠前的模型也经常做不到,发布前要逐条对一遍。提示词怎么把这些要求写清楚,见AI提示词怎么写:营销文案、海报和视频脚本模板。
做图要注意,文生图总榜反映的是整体投票结果,不是专门测“图里的中文字写得对不对”。做中文海报、商品主图时,先用自己的真实文案试几张,看清字有没有错再选模型。生图的具体做法见AI生图怎么做:5步一键生图与提示词,视频的几种生成方式见AI生成视频的4种方式。
AI大模型排名怎么查、会变吗
AI大模型排名会变,而且变得很快:LMArena 的文本榜和文生图榜分别在 10 月 27 日、26 日刚更新过,SuperCLUE 官网首页 10 月 30 日也有新的专项榜更新。看任何一份“十强”名单,先找三样东西:
- 核对日期和榜单版本:比如 SuperCLUE 是“2026 年 7 月总榜补充版”,LMArena 页面顶部写着更新日期。没写日期的名单不要用。
- 评的是哪个版本:同一个模型常有 Max、Flash、Pro 等多个版本,分数差别不小,比如 DeepSeek-V4.1-Flash 71.81 分,DeepSeek-V4-Flash 65.60 分。
- 怎么评的:SuperCLUE 是固定考题打分,只给国内模型排名;LMArena 是用户投票,国内外一起排。两份榜的名次不能直接对比。
查原始数据就看官网:SuperCLUE 中文大模型测评基准、LMArena 文本排行榜。
国内大模型合规吗:看网信办备案
面向国内公众、具有舆论属性或社会动员能力的生成式 AI 服务,要通过网信部门履行备案或登记,这一点和排名无关。国家网信办 2026 年 9 月 14 日的公告显示,截至 2026 年 8 月 31 日,累计 1112 款生成式 AI 服务完成备案,731 款应用或功能完成登记。
已上线的应用或功能,要在显著位置或产品详情页公示所用模型的名称、备案号或上线编号。选工具时,可以先在它的产品页找这一条;网信办的公告只列备案信息,不排名。备案名单怎么查、大模型本身是什么,见AI大模型是什么:原理与3类模型。
营销团队怎么用这些榜单选模型
营销团队选模型,看榜单只能缩小范围,最后还是要用自己的资料实测。我们建议按这个顺序:
- 先定用途:写文案、做图、做视频分开选,不要指望一个模型全包。
- 从对应榜单里挑 2–3 个:文字看 SuperCLUE 前几个名次,图片、视频看 LMArena 对应榜单里的国产模型。
- 用同一份资料实测:同样的产品资料、同样的提示词,各生成 3 次,看事实有没有写错、字数格式对不对、图上中文字对不对。
- 核对发布规则:AI 生成的内容发布时按平台要求打上 AI 标识;所用工具要能查到备案或登记信息。
如果不想自己拼几个工具,也可以用把这些环节串起来的营销 Agent。引擎AI(Deepege)是我们自己的产品:它先读你的产品手册、详情页和实拍素材,再写文章、口播和视频脚本,配好配音、字幕、封面后分国内版和海外版发布,中间的导演计划会停下来等你确认。官网没有公布它用的是哪个大模型,所以本页不把它放进任何排名。它和单个模型、智能体的区别,见引擎AI是什么、适合谁和AI智能体是什么。
我们怎么整理这份排名
- 核对日期:2026-10-30,全部数字来自当天打开的官网页面。
- 来源:SuperCLUE 官网总榜、LMArena 文本/文生图/文生视频榜、国家网信办备案公告。没有引用二手汇总站的名单。
- 没做的事:我们没有自己测模型、没有打分;不同榜单的名次没有合并成一个总排名。
- 没收录的情况:SuperCLUE 只列参评模型,LMArena 只列上榜模型;没出现在榜上的模型,本页不写名次。价格每家计费方式不同、变动快,本页不列。
参考资料(2026-10-30 核对):SuperCLUE 中文大模型测评基准(总榜)、LMArena 文本排行榜、LMArena 文生图排行榜、LMArena 文生视频排行榜、国家网信办:2026年7月至8月生成式人工智能服务备案信息公告、国家网信办:生成式人工智能服务已备案信息(汇总页)。
常见问题
国内AI大模型十强是哪些?
按SuperCLUE 2026年7月中文总榜(补充版)里每家公司最好的名次,十家依次是:阿里、DeepSeek(并列第1)、智谱、月之暗面(第2)、字节跳动(第5)、腾讯(第8)、MiniMax(第9)、百度、美团(第10)、小米(第11)。核对于2026-10-30。
豆包和DeepSeek哪个好?
SuperCLUE总分DeepSeek-V4.1-Flash 71.81分,高于豆包Doubao-Seed-2.1-pro的65.94分;DeepSeek在数学推理、幻觉控制、智能体编程上更高,豆包在科学推理、精确指令遵循和任务规划上更高。App里用的版本可能和榜上不同,具体任务最好用同一份资料实测。
世界AI大模型排名第一是谁,国产模型排第几?
LMArena 2026年10月27日的文本总榜第1名是Google的Gemini 4 Carbon (High);国产模型最高的是月之暗面Kimi K3 (Max),排第19,名次区间10–30。
AI大模型排名会变吗,在哪查?
会,而且变得很快。原始数据看SuperCLUE和LMArena官网,先看核对日期和榜单版本、评的是哪个模型版本,以及是固定考题打分还是用户投票,两份榜的名次不能直接对比。
排名靠前的大模型写营销文案一定更好吗?
不一定。SuperCLUE补充版18个模型的精确指令遵循分数全部低于50分,最高是DeepSeek-V4-Pro(max)的49.52,字数、格式、必写信息这类要求经常做不到。用自己的产品资料实测,发布前逐条核对。